


注目ベンチャー紹介:Robocurve
2026
.
10
.
23
Written by Yuhei Yano
今回の注目ベンチャーの紹介はRobocurveです。
VLA(Vision-Language-Action)やLLMなどのAIモデルが、実世界のロボット上でどの程度タスクを遂行できるかを標準化された条件で評価する、Physical AI向けの評価プラットフォームです。
Robocurve
サービス/プロダクト概要
- 大きく2つのサービスを展開している。
- 1つ目は、AIモデル・ロボット・評価項目を共通の仕組み上で接続し、同じ条件で繰り返し性能を測定できるオープンソースの評価基盤である。評価用のソフトウェアや公開ベンチマークを無償提供することで、大学・研究者・モデル開発企業による利用を広げ、業界共通の評価方法として普及させることを狙っている。
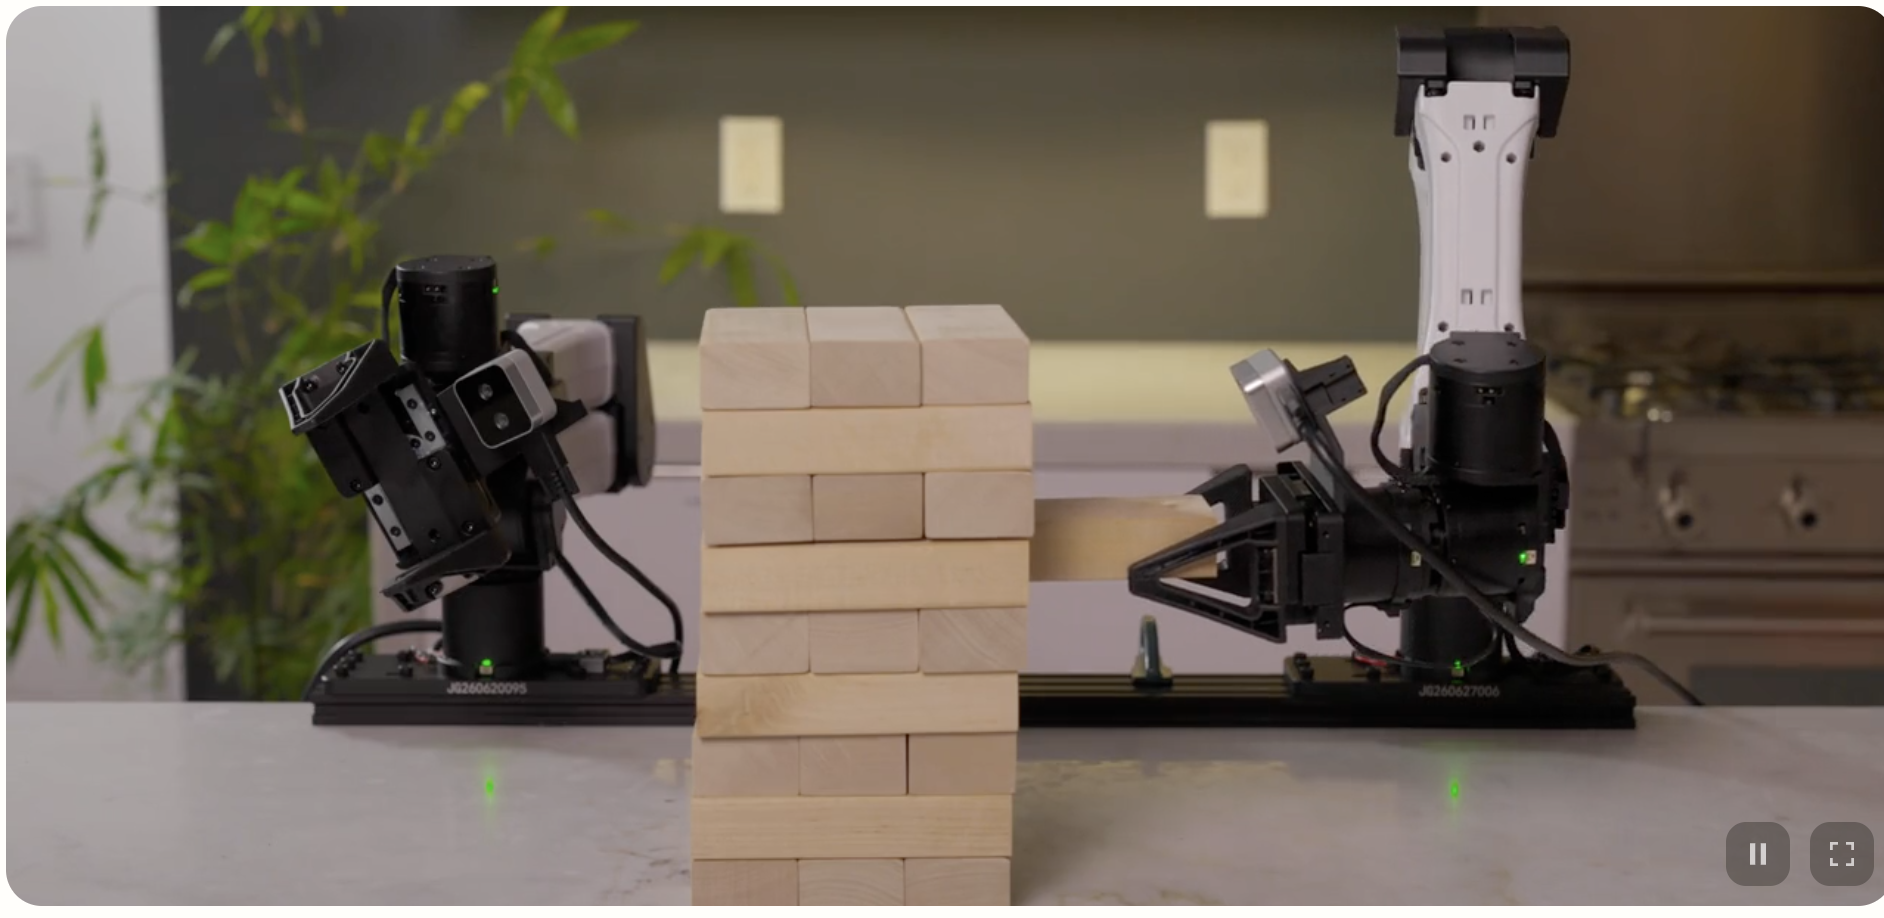
- 2つ目は、Robocurveが保有する多数の実機ロボットを使い、顧客のAIモデルを24時間自動で大規模に評価する商用サービスである。同一タスクを数十~数百回繰り返し、成功率や失敗パターンを測定する。評価用ロボットは夜間も含め自律稼働し、人手を介さず大量の試行を実行できることを特徴としている。
- ※ VLA(Vision-Language-Action):画像などの視覚情報と言語による指示を理解し、その結果をロボットの動作(Action)として出力するAIモデル。
特徴/提供価値
- 最大の特徴は、デモ映像やシミュレーション上の結果ではなく、実世界における標準化されたGround Truthを取得することにある
- ロボットの性能は、AIモデルだけでなく、ロボット本体、センサー、制御方式、物体配置、摩擦、照明など様々な条件によって変化する。そのため、各社が個別に公開するデモだけでは客観的な比較が難しい。同じタスク、同じ評価条件、同じ試行回数でモデルを比較することで、「どのモデルが実際に強いのか」を定量化する。
- また、モデルとロボットを分離して評価できるため、「Model A × Robot X」「Model A × Robot Y」のような組み合わせごとの性能差も測定可能である。
- 長期的には、単なる評価ツールではなく、Physical AIにおけるMLPerf、METR、あるいはUL/SGSのような第三者評価・認証レイヤーになることを目指している。
- ※ Ground Truth:AIやシミュレーションによる予測ではなく、実際の現実世界でロボットを動かして得られた「成功した/失敗した」といった正解となる実測データ。
- ※ MLPerf:AI半導体やAIシステムの性能を共通条件で比較する業界標準のベンチマーク。
- ※ METR:高度なAIモデルが実際の複雑なタスクをどこまで自律的に遂行できるかを第三者として評価する組織。
- ※ UL / SGS:製品の安全性や性能を第三者として試験・検査・認証する世界的な認証機関。
ビジネスモデル
- 商用サービスでは、実機での評価Trial数に応じた従量課金モデルを採用しており、1 Trialあたり概ね10~100ドルを想定している。1つのBenchmarkは100~200のタスク、それぞれ50~100回程度の試行から構成されるため、大規模評価では数十万~数百万ドル規模の契約になり得る
- 一方、オープンソースの評価ソフトウェアや公開ベンチマークは無償で提供し、大学や研究者、モデル開発者による利用を広げる。これによって業界標準としての地位を築き、その上で、
- 非公開モデルの評価
- 大規模な実機試験
- 競合モデルとの非公開比較
- 第三者認証
- 企業の調達判断向け評価レポート
- 将来的な規制対応試験
つまり、「評価方法や標準はコミュニティに開放し、その標準に基づく大規模・高品質な実機評価の運用で収益化する」モデルである - ※ Benchmark(ベンチマーク):複数のAIモデルやロボットの性能を公平に比較するために、同じタスク、条件、試行回数、採点方法を定めた「共通テスト」。複数のタスクをまとめた評価セットを指す場合もある。
市場動向・なぜこの会社なのか?
- LLMでは、Arena、METR、MLPerf、Patronus AIなど、モデル性能を第三者が評価する市場が既に形成されつつある。一方、Physical AIでは、ロボット、VLA、World Modelなどが急速に進化しているにもかかわらず、実世界で性能を横断比較する共通評価基盤はまだ確立していない。
- 特にPhysical AIでは、Model × Robot × Task × Environmentの組み合わせが膨大になるため、モデル更新のたびに継続的な評価が必要になる。Robocurveが取得するデータは、単なるロボット映像ではなく、同一条件下で取得された「Model・Robot・Task・Action・Outcome」を紐付けた実世界の実験データであり、取得難易度と希少性が非常に高い。
- World ModelやSimulationが進化すれば、実機Trialの一部は代替される可能性がある。一方で、Simulationが現実世界を正しく再現できているかを確認するためにはReal-world Ground Truthが必要となる。そのためRobocurveは将来的に、ロボットPolicyだけでなく、World Modelそのものを校正・評価するGround Truth Layerへ発展する余地がある。
- また、標準化にはBenchmarkの技術的信頼性だけでなく、大学、AI Lab、Robot OEM、企業ユーザー、標準化機関を巻き込んだConsensus形成が重要になる。大学には新しいBenchmarkを作るインセンティブはある一方、何年にもわたりロボットを維持し、継続的に評価を実行するインセンティブは弱い。
- そのため、大学や研究コミュニティが新しい評価方法・タスクを開発し、Robocurveが実機設備を維持して継続的に評価を運用するという役割分担が重要になる。Robocurveがこの仕組みを構築できれば、コミュニティの知見を取り込みながら、長期的な運用を担う企業としてのポジションそのものが参入障壁となる可能性がある。
-
顧客・競合・パートナー
- 顧客:Frontier AI Lab、VLA・World Model開発企業、Robot OEM、AI Safety関連機関などである。将来的にはAmazon、Toyota、Foxconnなどのロボット導入企業が、調達時に第三者評価を求める市場へ拡大する可能性もある。
- 競合:AnthropicなどのAI Labが持つ内部評価基盤や、VLA-Arena、各種Academic Benchmarkが存在する。また、Axis RoboticsのようにTraining Data、Simulation、Real-world Dataを統合する企業もEvaluation機能を持つ。
ただしAxis Roboticsが主として「モデルを改善するためのData Engine」であるのに対し、Robocurveは「モデル性能を独立第三者として測定するEvaluator」を志向しており、特定のモデルやロボットメーカーに属さない中立性が重要な差別化要素となる。
- また、Physical AI Safety Consortiumなどの産学連携や、NISTをはじめとする標準化機関との連携も重要となる。最終的には、Robocurve自身が一方的にBenchmarkを決めるのではなく、大学・AI Lab・Robot OEM・ユーザー企業が共同で標準を策定し、Robocurveがその評価を継続的に実行する形が理想的である。